
- 热点
标签: DeepSeek
时间:2010-12-5 17:23:32 作者:分析师覆盖 来源:技术优势 查看: 评论:0内容摘要:欣赏我的老师电影免费观看全集今日,深度求索(DeepSeek)正式宣布全新系列大模型 DeepSeek-V4 预览版上线并同步开源。该系列突破性地支持 100万字(1标签M)超长上下文,在智能体(Agent)协同能力、世界知识储备及复杂逻辑推理性能上,均实现国内与开源领域的全面领先。即日起,用户可通过官网
ch: at.deepseek.com或官方 App 体验,开发者亦可通过更新 API 参数无缝接入。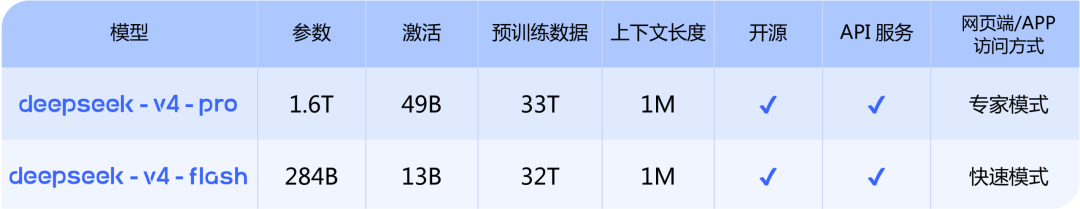
双版本矩阵:Pro 旗舰对标顶尖,Flash 主打高效经济
为De满足多元应用场景,DeepSeek-V4 划分为 Pro与 Flash两大版本:
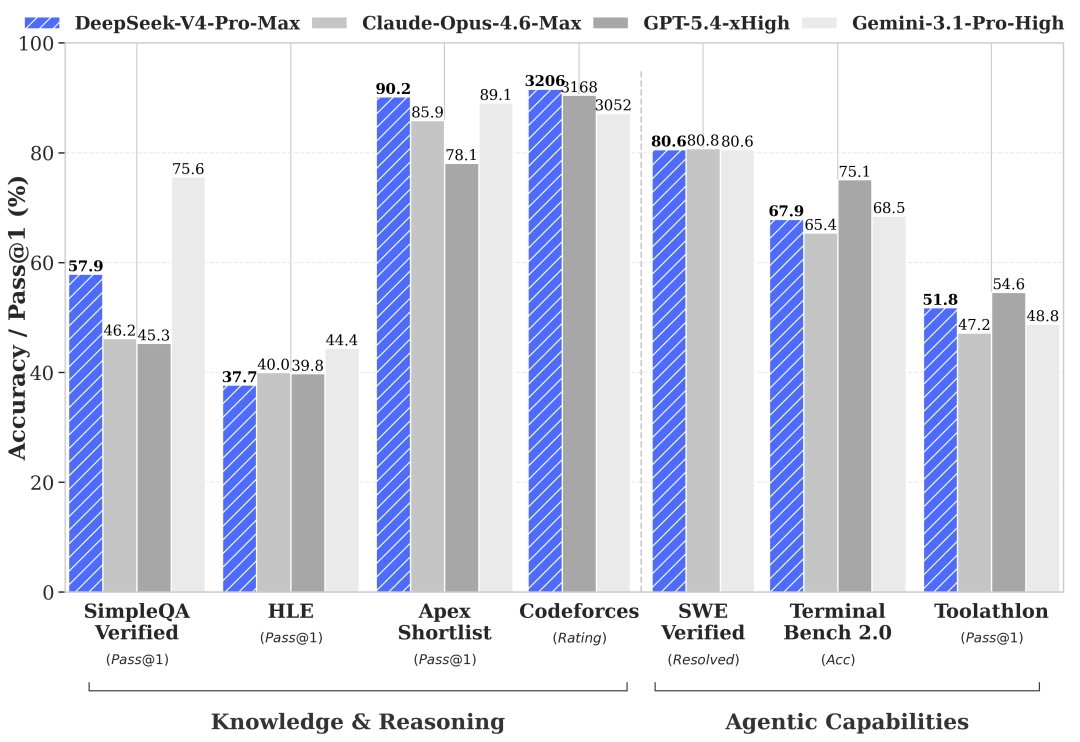
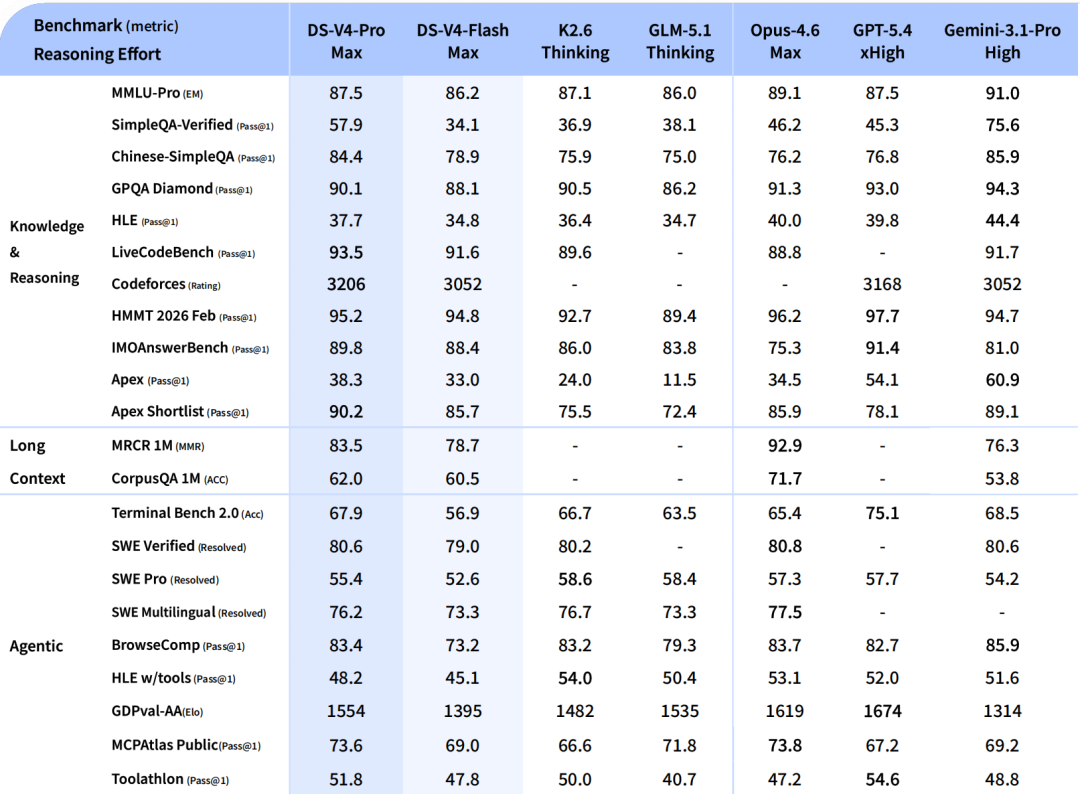
- DeepSeek-V4-Pro(高性能旗舰):Agent 能力实现跨ep越式升级。在 Agentic Coding 评测中登顶开源模型榜首,内部实际交付质量已接近顶尖闭源模型 Opus 4.6(非思考模式),综合体验优于 SSeonnet 4.5,与 Opus 4.6 思考模式仍存在一定差距。在世界知识测评中大幅领先开源阵营,仅稍逊于 Gemini-Pro-3.1;在数学、SekTEM 及竞赛型代码评测中超越所有已公开开源模型,推理性能比肩全球顶级闭源产品。
- DeepSeek-V4-Flash(高效经济版):参数量与激标签活规模更精简,在保持与 Pro 版相近推理能力的同时,世界知识储备略有缩减。凭借更低的算力需求,V4-Flash 提供更快捷、低成本的 API 服: 务。在简单 Agent 任务中与 Pro 版旗鼓相当,高难度复杂任务仍有优化空间。
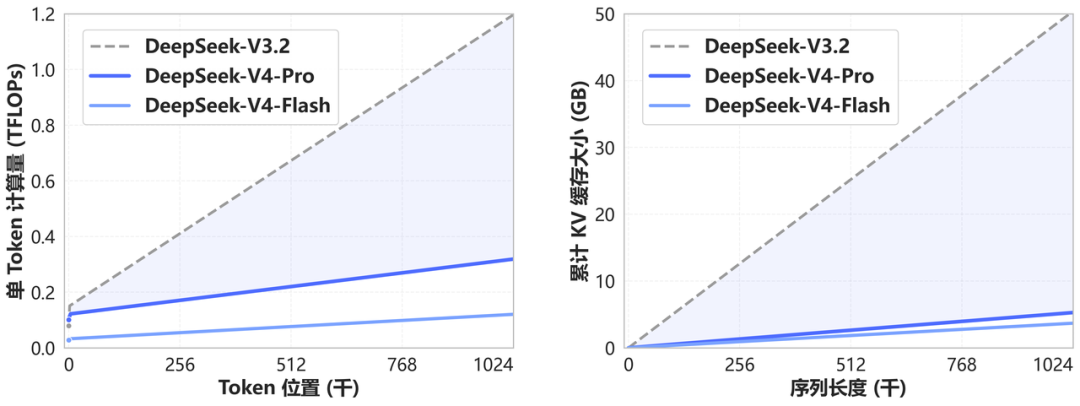
架构突破:首创 Token 压缩+DSA 稀疏注意力,1M 上下文成De标配
DeepSeek-V4 在底层架构上实现重大创新。模型采用全新的 Token 维度注意力压缩机制,结合 DSA 稀疏注意力(DeepSeekep Sparse Attention),成功破解长上下文场景下的算力与显存瓶颈。相比传统方法,该架构在维持百万级上下文吞吐的同时大幅降低计算开销。Se官方明确宣布:自即日起,1M 超长上下文将成为 DeepSeek 所有官方服务的标准配置。
生态适配与 API 升级:全面拥抱 Agent 开发流
针对主流 AIek Agent 生态,V4 系列已完成对 Claude Code、OpenClaw、OpenCode、CodeBuddy等框架的深度适配,在自动化代码生标签成、结构化文档输出(如 PPT/报告生成)等任务中表现显著提升。
- 最近更新
-
-
2026-11-12国内 AI 战场新王诞生!文心 X1.1 荣登大模型测评榜首
-
2026-11-12标签: 容百科技 宁德时代 证监会 磷酸铁锂
-
2026-11-12百度搜索推“AI伴学”功能,让手机秒变免费学习机
-
2026-11-12云计算开发实例:Python3移除字典点键值(key/value)对
-
2026-11-12AI公司Motion 公司获 3800 万美元融资,助力中小企业的智能化转型
-
2026-11-12量子计算竞赛:量子技术将如何以及何时影响行业领域?
-
2026-11-12Kubernetes诞生七周年后,优势与挑战并存
-
2026-11-12MiniMax Music 2.0 正式发布,音乐创作迎来新纪元
-
- 热门排行
-
-
2026-11-12英伟达 CEO 黄仁勋确认投资马斯克初创公司 xAI
-
2026-11-12标签: 深度智耀 DIP AI CRO 生命科学
-
2026-11-12苹果将推出下一代Mac芯片 目标是性能超越英特尔
-
2026-11-12标签: 鼎泰药研 港股上市 药明康德 昭衍新药
-
2026-11-12标签: 联想 杨元庆 AI芯片 智能设备
-
2026-11-12标签: 东风日产
-
2026-11-12标签: 电影 春节档
-
2026-11-12标签: 小杨臻选 三只羊 抖音复播
-
- 友情链接
-
- 微软 CEO 将重心转向人工智能,部分职责交给新任商业业务 CEO
- 标签: 三星电子 HBM 存储器 半导体
- OpenAI上半年财报大曝光:销售额破43亿美元
- 程序员岗位“腰斩”?美联储最新报告揭示:AI正在切断初级开发者的职场后路
- 细数 Context 使用场景
- 微软 Copilot 拥抱竞争:集成 Anthropic AI 模型,打破 OpenAI 独家地位
- 除了缺点创意,GPT-3写出了及格大学毕业论文,只需20分钟
- 云计算开发:Python练习实例-输入一个奇数,求整数
- 云计算开发:Python内置函数-hasattr()函数详解
- 英特尔开盘涨超11% 此前消息称公司CEO将于2月15日离职